Loading...
← All posts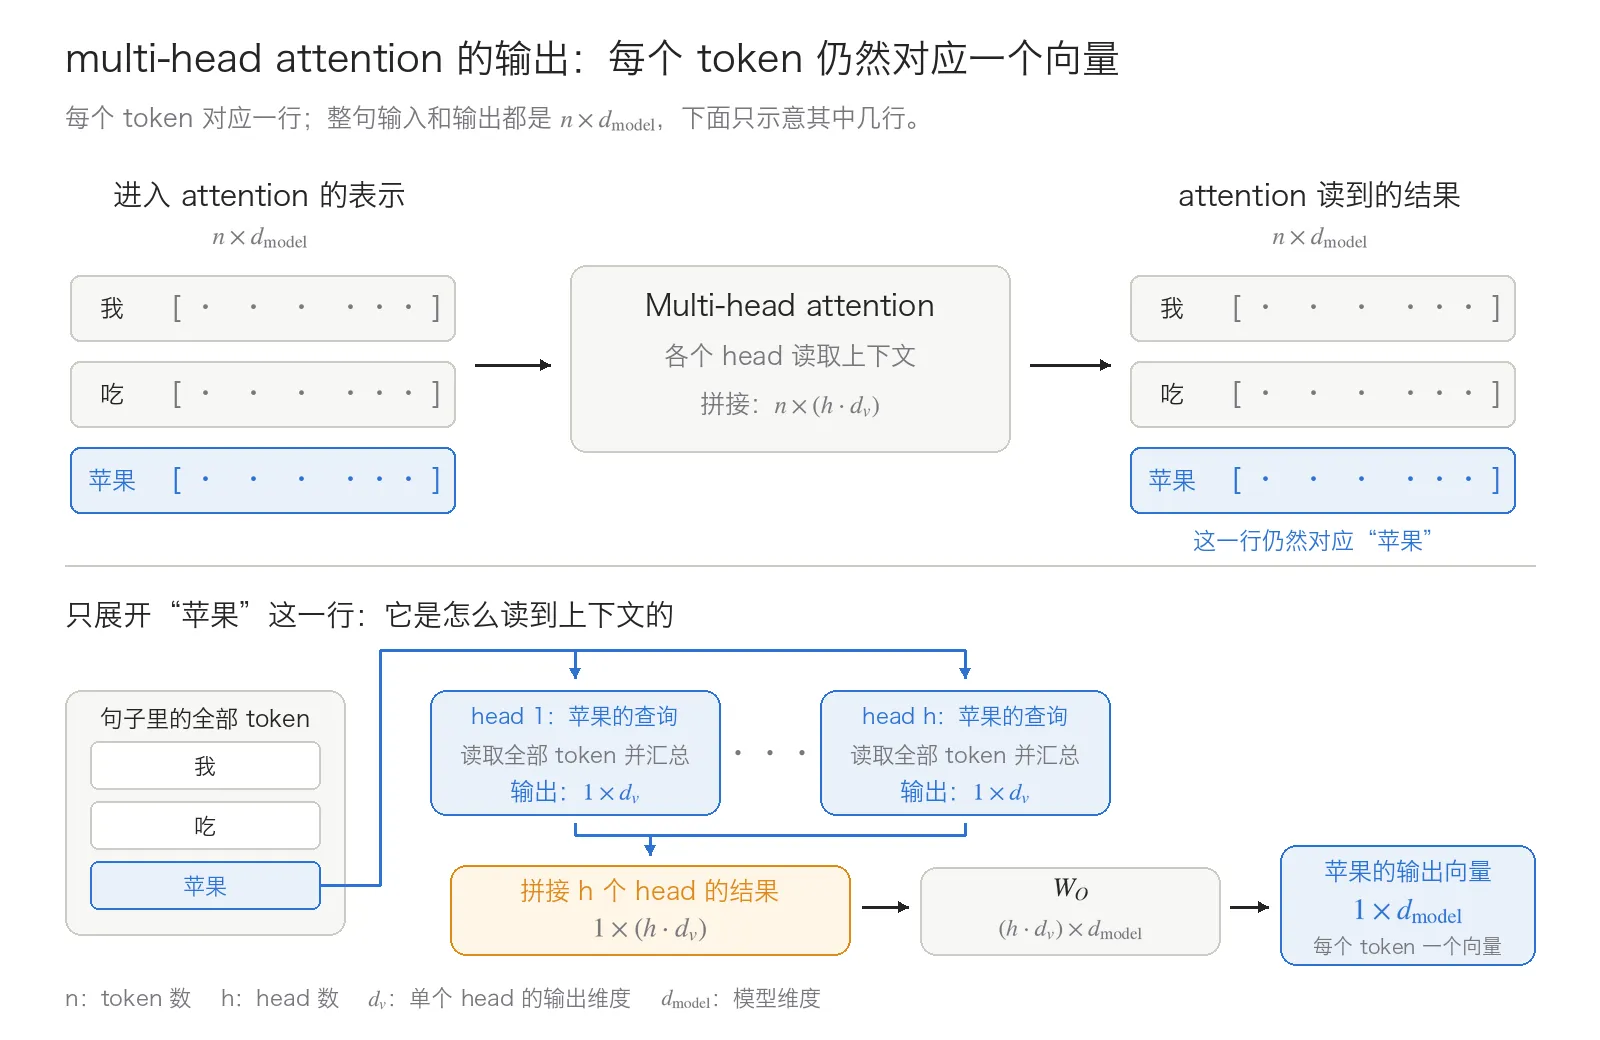
多头注意力输出与输入 token 逐行对应。下半图从“苹果”出发,展开各 head 的汇总、拼接和输出投影。图中已标注各步尺寸,尚未加回输入或做 LayerNorm。
Transformer(6) - LayerNorm
拿一个四维向量手算 LayerNorm:按哪一维统计,减均值、除标准差各在做什么,γ 和 β 怎么用,以及它在 Transformer 里的位置。
Transformer(5) - multi-head attention 最后把各个 head 的结果拼起来,再乘一个输出矩阵 ,得到一个 的矩阵。先不急着往下走,看看这个结果到底表示什么。
attention 算完以后,得到了什么
还是用前面的“我 吃 苹果”。输入时,每个 token 有一个自己的向量;multi-head attention 算完以后,每个 token 又得到一个向量,长度仍然是 。
拿“苹果”这一行来说,它是“苹果”从整句话里读到的信息:每个 head 按自己的关注方式,把其他 token 的信息加权汇总,再由 融合起来。在“我 吃 苹果”里,它可以从“吃”那里读到与食物有关的信息;换成“苹果 发布 手机”,读到的上下文就不同了。
所以输出的每一行,都对应原来那个位置上的 token,但内容已经参考了整句话。它仍然是一串供后续网络计算的数字,最终的词表概率还要经过后面的处理才能得到。
那这一串数字该怎么看?和 embedding 一样,它是模型学出来的一组特征。真实模型通常不能给每一维都起一个明确的名字,比如“第 1 维就是水果,第 2 维就是公司”。有用的含义往往分散在多个维度里,我们先把它当成模型内部描述上下文的一组坐标。
接下来:先加回输入,再做归一化
在原版 Transformer 里,attention 的输出还要加上进入 attention 之前的向量。也就是让每个 token 保留原来的表示,同时加上这次从上下文读到的结果。这一步叫残差连接,后面再单独讲。
为了看清数字怎么接上,假设“苹果”只有 4 维,做一个手算用的例子
进入 attention 前:[1, 1, 2, 3]
attention 的输出:[1, 3, 4, 5]
对应位置相加:  [2, 4, 6, 8]
最后这行 ,才是接下来要交给 LayerNorm 的向量。数字是为了演示选的,不是从真实模型里读出来的,也不代表 4 个预先规定的语义属性。
假设整句话相加以后的结果是下面这样,每一行都是“原来的表示 + attention 读到的结果”
| token(示意) | 第 1 维 | 第 2 维 | 第 3 维 | 第 4 维 |
| 我 | 8 | 6 | 4 | 2 |
| 吃 | 20 | 40 | 60 | 80 |
| 苹果 | 2 | 4 | 6 | 8 |
这里就能看到接下来的问题:“吃”这一行的数值整体比“苹果”大 10 倍。如果直接交给同一套矩阵乘法,算出来的结果也会差 10 倍。向量经过一层层计算,整体尺度和偏移都可能变化,给后续计算和训练带来影响。
这组数恰好相差 10 倍,只是为了方便比较,不表示“吃”和“苹果”的真实表示应该成比例,更不表示“吃”的含义更强。
LayerNorm 就接在这里:分别根据每一行自己的均值和标准差,调整整体偏移和尺度,再用可学习参数调整各个维度。下面就从“苹果”这一行开始算。
先分清:到底对哪些数做归一化
看上面的表,LayerNorm 是横着一行一行处理的:“我”用自己的 4 个数算一次,“吃”用自己的 4 个数算一次,“苹果”也一样。每个 token 都有自己的均值和标准差。
它不会把整张表凑起来算,也不会把三个 token 的第 1 维拿到一起算。输入仍然是 ,输出大小不变;这一步只整理每一行,读取其他 token 信息的工作已经由前面的 attention 做过了。
手算一遍
先看“苹果”这一行 。
(一) 减去平均值
平均值是
每个数减去 5,得到 。原来整组数围绕 5,现在围绕 0。哪个数高于平均值、哪个低于平均值,都能直接看出来。
但只减均值还不够。“吃”这一行减去自己的均值 50,得到 ,仍然比“苹果”这一行大 10 倍。还需要把波动的大小也调整一下。
(二) 除以标准差
先算各个数离平均值有多远,平方以后求平均,得到方差
再开平方,得到标准差 。标准差可以粗略理解成这组数偏离平均值的程度:波动越大,它就越大。
把刚才每个数都除以标准差,得到
现在 −1.342 表示低于平均值约 1.342 个标准差,0.447 表示高于平均值约 0.447 个标准差。相当于换成了一套共同的计量方式。
再算“吃”这一行。它减均值后是 ,标准差是 ,除完以后,恰好得到与“苹果”这一行相同的结果。
(三) 加一个很小的 ε
实际计算用的是
是事先设定的一个很小的正数,用来避免方差为 0 时除以 0,也能缓和方差特别小时的数值问题。前面的手算为了清楚,暂时忽略了它。
比如输入是 ,减均值以后全是 0,方差也是 0。有了 ,就能正常得到全零向量。
忽略 时,这一步结果的均值为 0、方差为 1;加上它以后,方差通常接近 1,而不是严格等于 1。
都归一化了,不同 token 会不会变成一样
不一定。上面“苹果”和“吃”的示意向量得到同样的结果,是因为它们恰好只差一个整体缩放。如果把“苹果”向量的中间两维交换一下,变成 ,归一化以后就是
原来:[2, 4, 6, 8] → [-1.342, -0.447,  0.447, 1.342]
交换:[2, 6, 4, 8] → [-1.342,  0.447, -0.447, 1.342]
哪些维度高、哪些维度低,仍然不同。LayerNorm 没有把每个数都变成同一个数,也没有把不同维度重新排序。
不过它确实会丢掉整体均值和尺度的信息,不能说“所有信息都保留了”。上面的两个示意向量就是例子:只看归一化结果,已经分不清原来是 还是 。模型是在包含这一步的结构里一起训练的,需要把有用的区别学到归一化后仍能区分的表示里。
那为什么还需要 γ 和 β
归一化以后,各维度都按同一套规则处理。但模型可能希望某一维放大一点,另一维整体偏高一点,所以还有一步
和 各是一个 维向量,每一维都有自己的缩放和偏移。比如第 1 维的 、,刚才的 −1.342 就会变成
其他维度按各自的参数来算。 通常初始化成全 1, 初始化成全 0,之后跟模型一起训练。
这里还要分清:均值、方差是每个 token 临时算出来的;同一个 LayerNorm 模块的 、,则是所有 token 共用的参数,不是每个 token 各学一套。不同模块通常有各自独立的一套。
它们也不能把刚才丢掉的信息恢复出来。上面的两个示意向量归一化以后相同,再乘同一组 、加同一组 ,结果仍然相同。它们提供的是可学习的调整能力,不是把原向量还原回来。
合在一起
对一个 维向量,完整计算就是
表示对应位置相乘,不是点积。输入一个 的矩阵,就对每一行做上面这套计算,输出仍然是 。
还要注意,均值 0、方差约为 1,说的是乘 、加 之前的结果。完整 LayerNorm 的最终输出,不再保证满足这两个条件。PyTorch LayerNorm 文档
为什么不按 batch 来算
BatchNorm 是另一种归一化方式。它通常针对某个特征,把一批样本中的值放到一起算统计量;LayerNorm 则针对一个 token,把它自己的各个特征放到一起算。
最直接的区别是:用 LayerNorm 处理“苹果”时,不需要知道同一个 batch 里还放了哪些句子。训练时一次处理很多句子,生成时一次只处理一个新 token,都能用同一套计算方式,也不需要维护训练期间的滑动均值和方差。
这不表示 BatchNorm 不能处理一条样本,它推理时通常会使用训练中积累的统计量。只是对序列模型来说,LayerNorm 这种不依赖其他样本的方式更方便。Layer Normalization 论文
它在 Transformer 的什么位置
原版 Transformer 结构图里写的是 Add & Norm。Add 指把模块的输入加回输出,也就是残差连接;Norm 才是这一篇讲的 LayerNorm。以 attention 这一支为例,忽略 dropout,可以写成
所以原版并不是 attention 算完就直接归一化,中间还加回了输入。前馈网络那一支也有对应的 Add & Norm。后来也有把归一化放在模块前面的设计,看不同结构图时要留意位置,不能都画成同一个顺序。原版 Transformer 结构
这一篇先弄清 Norm 本身,残差连接和它为什么有用,再单独展开。
小结
LayerNorm 是对每个 token 的向量单独处理:减去自己的均值,除以自己的标准差,再按维度乘上可学习的 、加上 。它不混合其他 token,也不改变向量长度。
前面 attention 解决的是“从上下文里读到什么”,LayerNorm 调整的是这份表示的整体偏移和尺度。把这两件事分开,再看 Transformer 的结构图就容易一些。